
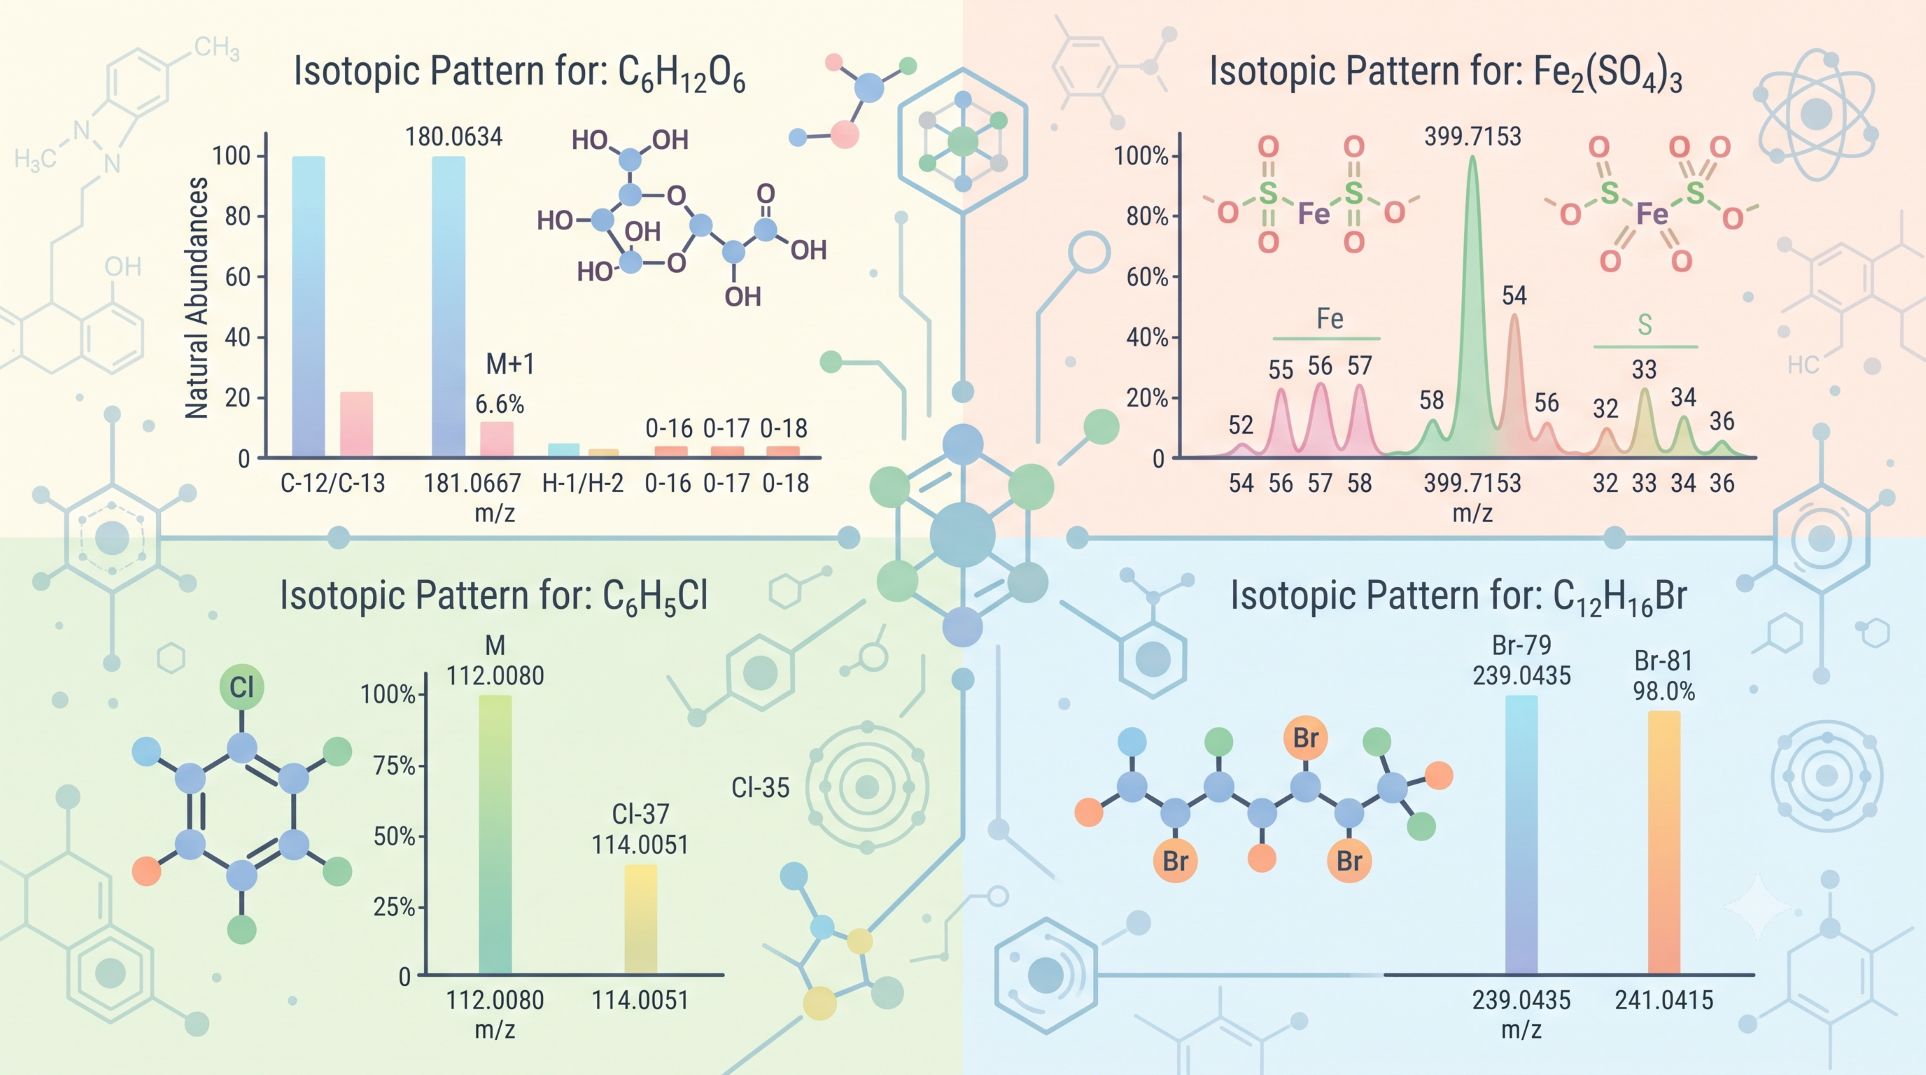
El patrón isotópico es la distribución de abundancia relativa que presentan los distintos isótopos de una molécula al ser analizada en un espectrómetro de masas. Cada elemento químico tiene isótopos naturales con distinta masa y distinta probabilidad de aparecer (por ejemplo, el carbono tiene C-12 y C-13, el cloro tiene Cl-35 y Cl-37), y esa combinación de probabilidades es lo que genera la primera”huella dactilar” de una molécula que se observa en un espectro.
En Espectrometría de Masas de Alta Resolución (HRMS), entender el patrón isotópico es importante por dos razones prácticas: primero, permite confirmar la identidad de una molécula comparando el patrón teórico con el observado (si no coinciden, algo anda mal con la fórmula propuesta o la muestra); segundo, permite saber dónde buscar exactamente el peak de mayor intensidad, que no siempre es el peak monoisotópico. En moléculas orgánicas simples compuestas solo por C, H, O y N, el peak monoisotópico (la combinación de los isótopos más abundantes) suele coincidir con el peak más intenso del espectro. Pero apenas se incorporan halógenos (Cl, Br) o metales de transición, la distribución isotópica cambia drásticamente, y el peak más intenso puede desplazarse una o incluso varias unidades de masa más allá del monoisotópico. Sin este conocimiento, es fácil buscar en el lugar equivocado del espectro y no encontrar la señal esperada.
En este artículo explico cómo desarrollé un flujo de trabajo en Python para automatizar la identificación de las masas exactas necesarias para mediciones por Inyección Directa en HRMS, y cómo terminé desplegándolo como una aplicación web con Streamlit para uso diario en el laboratorio.
El desafío de escalar muestra en el trabajo diario
El grupo de mayores usuarios en la Unidad de Espectrometría de Masas son los químicos. Suelen buscar la corroboración de moléculas que ellos sintetizaron o purificaron, comparando su masa exacta y, en ocasiones, su patrón de fragmentación.
Al principio recibía menos de 10 muestras por lote. Con los años, hoy en día podemos llegar a más de 100. Si en un comienzo bastaba con una hoja de cálculo donde podia tipear el nombre de la muestra, su fórmula molecular y su masa monoisotópica leyendo del formulario de muestras en unos pocos minutos, ese mismo proceso al escalar de 4 a más de 100 muestras por lote, se convirtió en un cuello de botella importante.
Cómo cambia el patrón isotópico según los átomos presentes
No todos los elementos afectan el espectro de la misma manera. Como referencia rápida:
- Moléculas con solo C, H, O, N: el patrón es relativamente simple; el peak monoisotópico suele ser también el más intenso, con peaks secundarios (M+1, M+2) de baja intensidad debido al C-13 y al O-18.
- Moléculas con un átomo de cloro (Cl): aparece un peak M+2 muy característico, con una intensidad relativa cercana al 32% del peak principal, producto del Cl-37.
- Moléculas con bromo (Br): el patrón M+2 es aún más marcado, con una intensidad cercana al 98% del peak principal —prácticamente dos peaks de altura similar—, por la abundancia casi 1:1 entre Br-79 y Br-81.
- Moléculas con metales de transición (Fe, Cu, Ni, entre otros): suelen tener múltiples isótopos estables con abundancias muy distintas entre sí, generando patrones más complejos y donde el peak más intenso frecuentemente no es el monoisotópico.
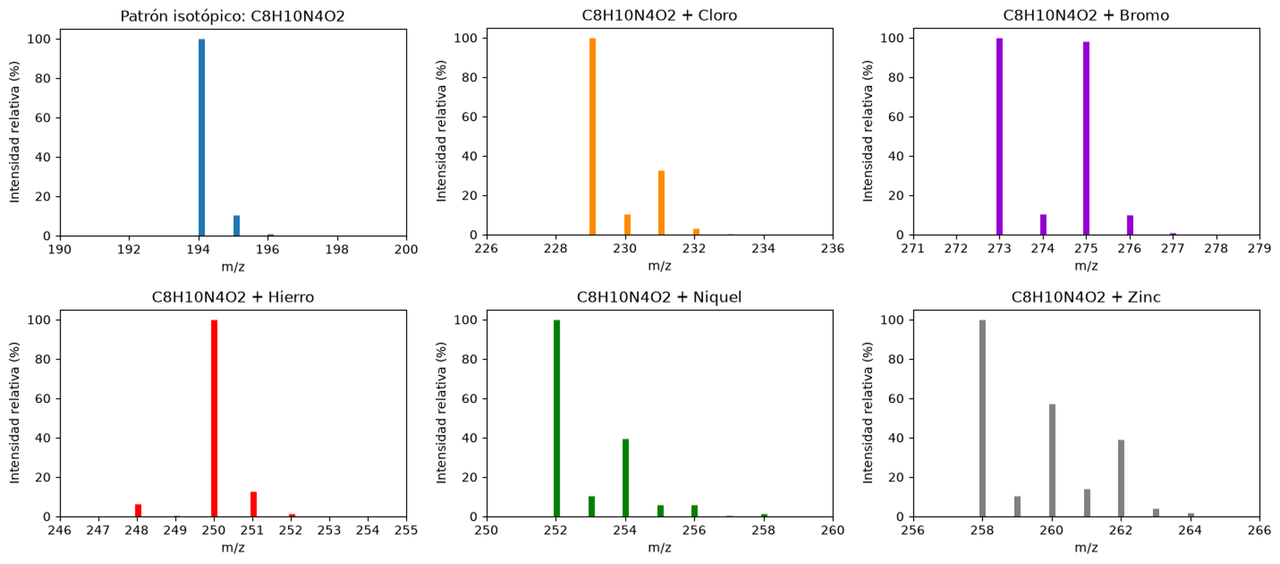
La molécula detectada en el espectrómetro tiene cambios
Para predecir el comportamiento de ionización real en el espectrómetro, el algoritmo debe simular la adición o pérdida de protones según el modo de operación:
- Modo positivo [M+H]+: suma la masa de un protón a la fórmula, quedando con carga +1.
- Modo negativo [M-H]-: resta un protón a la fórmula, quedando con carga -1.
Utilizando la librería molmass, el script calcula la simulación completa de la distribución isotópica y extrae el valor de m/z correspondiente al peak de mayor abundancia relativa, garantizando que el peak a buscar en los resultados pueda ser detectado rápidamente.
Implementación en Python y despliegue en Streamlit
Para optimizar el flujo de trabajo, desarrollé un script en Python que permite obtener rápidamente el peak más abundante a partir de la fórmula molecular de cada muestra.
El código está disponible en la carpeta de Github “Inyeccion directa”.
Flujo de trabajo:
- Cargar archivo
.csvcon las columnasMuestrayFormula. - Selección del modo de ionización (positivo/negativo).
- Obtención automática de la masa monoisotópica y del espectro simulado.
- Exportación de resultados listos para la corrida analítica.
El script requiere un .csv con las columnas “Muestra” y “Formula”, y construye un dataframe con la información. Luego, usando molmass, se obtiene la masa monoisotópica de la molécula y se aplica una función que suma o resta un ion de hidrógeno a la fórmula, según corresponda al modo de ionización. Con esto se obtiene el espectro y su patrón isotópico, y se recupera el valor de masa del peak con mayor intensidad.
Finalmente, con ayuda de un LLM, adapté el script para funcionar sobre la plataforma Streamlit. De esa manera puedo visitar rápidamente una página web y usar el script directamente, sin depender de tener el entorno de Python configurado en cada equipo del laboratorio.
